上一篇《LangChain 核心概念》已经介绍了“检索资料 → 填入提示词 → 调用模型”的流程,以及各组件之间怎样传递数据。本篇在此基础上,进一步解释向量检索的原理和 LCEL 的实现方式。
假设要做一个退款问答助手。用户问“钱怎么退回来?”,资料中写的是“退款申请步骤”。程序需要把这两种说法联系起来,找到退款规则,再根据规则回答。
本文就用这个例子理解向量、Embedding、VectorStore 和 Retriever,并运行一个简单的检索程序。最后再用 prompt | model | parser 接上回答步骤。示例中的退款规则是虚构的教学资料。
1. 先找资料,再让模型回答
假设资料里有下面两段内容:
1 | 退款规则:购买后 30 天内,可以在订单页面提交退款申请。 |
用户问“钱怎么退回来?”,程序应该找到退款规则。接下来,把问题和这段规则一起交给生成模型,让它组织回答。
1 | 用户问题:“钱怎么退回来?” |
这种“先取资料,再带着资料生成回答”的方法叫 RAG,检索增强生成。检索负责找资料,生成模型负责根据资料组织回答。
本篇采用向量检索来找资料。RAG 也可以使用关键词搜索、数据库查询或其他搜索服务,不要求每个系统都使用向量。
2. 向量是什么,Embedding 又做了什么
向量是一组有顺序的数字
可以先这样理解:
向量是一组有顺序的数字。在文本检索中,这组数字用来表示一段文字的特征,方便程序进行比较。
例如:
1 | [0.21, -0.35, 0.78] |
这里有三个数字,所以叫三维向量。若有 512 个数字,就是 512 维向量。维度由模型及其配置决定,不能仅凭维度更多就认定检索效果更好。
生活中,“向东 5 公里、向北 3 公里”可以用 [5, 3] 表示。两个数字的含义由人明确规定。文本向量同样有多个数字,但每个位置的含义由模型学习,通常不能直接解释成“第一位是退款、第二位是金额”。
Embedding 模型把文字转换成向量
Embedding 模型又叫嵌入模型。它接收文本,计算出代表这段文本的向量:
1 | “钱怎么退回来?” |
上面的数字只是示意,不是实测输出。编写应用时,通常只需要调用模型提供的编码方法,不需要自己决定每个数字是多少。
模型内部会先把文字拆成小单位,再结合上下文进行计算,最后得到整段文字的向量。训练时,模型会学习让相关文本的向量更容易匹配。因此,“钱怎么退回来?”与“退款申请步骤”即使用词不同,也有机会被判断为相关。Embedding 模型结构说明
它与“给文字编号”不同。编号 001、002 只能区分两条记录,不能说明内容是否相近;经过训练的文本向量则可以用来计算相关程度。
这里有两个模型,作用要分清:
| 模型 | 输入 | 输出 |
|---|---|---|
| Embedding 模型 | 一段文字 | 一组数字,用于检索 |
| 生成模型,也就是后面回答问题的 LLM | 问题和参考资料 | 一段回答 |
Embedding 模型算出数字后,并没有回答退款问题。回答发生在找到资料之后。
3. 向量怎样找到相关资料
程序先把资料转换成向量保存起来。收到问题时,再把问题也转换成向量,与资料向量进行比较。
1 | 问题:“钱怎么退回来?” → 问题向量 |
为了看清“比较”的意思,下面用一组手写的二维向量演示。它们只用于说明计算,不代表真实模型输出。
| 内容 | 向量 | 与问题的余弦相似度 |
|---|---|---|
| 问题 | [1, 0] |
— |
| 资料 A | [0.8, 0.6] |
0.8 |
| 资料 B | [0, 1] |
0.0 |
这里使用的余弦相似度主要比较向量的方向,分数越大,方向越接近。因此,这个例子会优先选 A。实际代码可以让向量存储完成计算,不需要自己手写公式。
还有其他比较方法。初次使用时,先知道它们的分数含义不同即可:
| 方法 | 直观理解 | 怎样选结果 |
|---|---|---|
| 余弦相似度 | 比较方向是否接近 | 分数越大越靠前 |
| 内积 | 同时受方向和向量长度影响 | 分数越大越靠前 |
| 欧氏距离 | 比较两个点相隔多远 | 距离越小越靠前 |
向量长度与维度有什么区别
把二维向量 [3, 4] 想成“从原点向右走 3,再向上走 4”。从起点到终点的直线距离,就是这里说的向量长度。根据勾股定理:
1 | 长度 = √(3² + 4²) = 5 |
所以,[3, 4] 有两个数字,维度是 2,长度是 5。对于更多维的向量,同样把每个数字分别平方、相加,再开根号,就得到它的长度。
后面代码中的“归一化”,就是把非零向量中的每个数字都除以原来的长度:
1 | 原向量:[3, 4] |
可以理解为把箭头按比例缩放,方向保持不变,长度变成 1。数字的个数没有变化;512 维向量归一化后,也仍然有 512 个数字。
比较方法怎样选择
先看具体 Embedding 模型推荐什么方法,再确认 VectorStore 使用的方法是否匹配。 这与模型的训练方式有关,不能只按“中文模型、英文模型”或者向量维度来选择。
还要看向量是否归一化。如果问题和文档向量的长度都变成了 1,那么内积与余弦相似度的计算结果相同;没有归一化时,两者可能得到不同的排序。距离与相似度说明
为什么长度都是 1 时,结果就相同?先看两种方法怎样计算:内积是对应位置相乘,再把结果相加;余弦相似度则在内积的基础上,再除以两个向量长度的乘积。
例如,问题向量为 [1, 0],文档向量为 [0.6, 0.8]。这些数字仍是教学示例,可以直接算出:
1 | 内积 = 1 × 0.6 + 0 × 0.8 = 0.6 |
两个长度都是 1,相当于把内积除以 1,所以结果不变。这里说的是用两种方法比较同一对向量,分数相同,并不表示两个向量本身相同,也不表示相似度一定为 1。上面的相似度就是 0.6。
Embedding 模型负责生成向量,实际比较由 VectorStore 完成。有些向量存储允许在创建集合或索引时选择比较方法,有些实现已经固定。本文的 InMemoryVectorStore 固定使用余弦相似度,不需要主动设置,也没有切换比较方法的参数。第 5 节会对照代码说明。
Top K 是取排名靠前的几条
检索时经常会设置 k=2,表示最多取排名靠前的两条资料,这就叫 Top K。
它不表示“一定找到了两条正确答案”。即使库中没有足够相关的内容,单纯按排名取结果,仍可能返回一些资料。相似度为 0.8 也不等于“答案正确率为 80%”。
另外,问题和资料要使用配套的嵌入模型。最容易操作的做法,是让同一个嵌入组件负责两边的编码。随意换一个模型来处理问题,即使向量维度相同,也可能无法与已经保存的资料向量正确比较。
4. Document、chunk 和检索组件怎样配合
先把两个容易混淆的名称说清楚:
- Document 是 LangChain 中保存文本的对象,
page_content放正文,metadata放来源等附加信息。 - chunk 就是“片段”,指从较长文本中切出来的一小段内容。
一个 chunk 通常也用一个 Document 对象保存。 切分前后使用的对象类型可以相同,变化的是其中保存的正文范围。
1 | 切分前: |
加载器先用 Document 保存读到的内容;切分器再把内容拆成多个 chunk,并分别用新的 Document 保存,供后续检索。
这样就能单独找到退款片段,不必把整份说明都交给模型。也不能切得过碎:如果只剩“需要在 30 天内提交”,却丢了“提交什么”,模型拿到的资料就不完整。
官方 Retrieval 文档的 Building Blocks列出的五类组件,可以放到同一个例子里理解:
| 组件 | 在退款问答中做什么 |
|---|---|
| Document Loader,文档加载器 | 读取退款说明文件,得到 Document |
| Text Splitter,文本切分器 | 把长说明拆成退款条件、操作步骤等片段 |
| Embedding 模型 | 把各片段以及用户问题转换成向量 |
| VectorStore,向量存储 | 保存向量与原文的对应关系,并提供向量搜索 |
| Retriever,检索器 | 接收问题,按配置的方式取回文档列表 |
VectorStore 保存什么
可以把其中一条记录理解成下面的结构。这只是说明数据关系,不是某个数据库的固定格式:
1 | 正文:购买后 30 天内,可以在订单页面提交退款申请。 |
保留正文很重要。搜索时比较向量,搜索完成后,交给生成模型的是对应的文字资料。程序不需要让生成模型猜测这组数字原来代表哪句话。
在 LangChain 中,VectorStore 是向量存储与搜索的操作接口。具体实现可以连接向量数据库,也可以像本文的 InMemoryVectorStore 一样直接使用内存。内存中的数据不会在程序退出后自动保留。
Retriever 与 VectorStore 是什么关系
Retriever 是应用程序使用的检索入口;VectorStore 提供底下的向量存储与搜索能力。
使用向量检索时,可以这样看它们之间的调用关系:
1 | 应用程序把问题交给 Retriever |
例如,VectorStore 保存着全部资料,Retriever 可以配置成“每次取两条”。创建 Retriever 不会重新创建数据库,也不会把所有资料再计算一遍。
Retriever 也可以使用关键词索引或其他搜索服务。因此,看到 Retriever 时,要继续看它具体使用了什么检索方式。
5. 动手做一次退款资料检索
下面按顺序执行,先完成“输入问题,返回相关资料”。这一部分使用真实的本地 Embedding 模型,不需要模型服务的 API Key,也不调用生成模型。
笔者使用 Python 3.12 验证了代码。先创建环境并安装依赖:
1 | python3.12 -m venv .venv |
langchain-huggingface 负责接入本地嵌入模型,[full] 会一并安装需要的模型运行依赖。首次加载模型需要联网下载,之后可以使用缓存。官方集成说明
下面第 5、6 节的 Python 代码按顺序放进同一个文件即可,也可以直接下载文末的完整示例。
第一步:读取资料,再切成片段
这段代码会在当前目录写入演示文件 refund-demo-notes.txt。其中两段与退款有关,一段与请假有关。
1 | from pathlib import Path |
本例用“读取文件,再创建 Document”的几行代码完成加载。遇到 PDF、网页等资料时,可以换成对应的 Document Loader,不必自己处理文件格式。
切分器的 chunk_size=40 表示每块最多按 40 个字符计量,默认不是按 token 计量;chunk_overlap=0 表示这里不安排片段重叠。本例的段落很短,切分器按空行把它们分成三块,实测会打印 片段数:3 和上面的三段原文。
40 只是这个小例子的设置。处理自己的长文档时,应先打印切分结果,检查每段能否独立看懂,再调整大小。
第二步:创建嵌入模型,把片段存进去
下面使用 BAAI/bge-small-zh-v1.5,它是一个能处理中文的嵌入模型。HuggingFaceEmbeddings 是 LangChain 提供的接入组件,用来加载和调用它。
1 | from langchain_huggingface import HuggingFaceEmbeddings |
device="cpu" 表示用 CPU 运行。normalize_embeddings=True 主动开启第 3 节解释的归一化:把每个数字除以向量长度,让长度变成 1,维度仍然是 512。本文沿用 BGE 官方示例中的归一化用法。模型说明
归一化设置与比较方法是两件事。 normalize_embeddings=True 控制如何处理生成的向量;InMemoryVectorStore 内部已经固定调用余弦相似度计算。即使关闭归一化,这个内存库也仍使用余弦,不会自动改成内积或欧氏距离。内存库的搜索实现
因此,本文不需要再写一个参数来选择余弦。以后更换 VectorStore 时,要查看它的固定行为或配置说明;更换 Embedding 模型时,也要重新核对两者的搭配。
这里最重要的是两行调用:
store.add_documents(chunks):由 store 调用嵌入模型,计算片段向量,再保存向量与原文。embeddings.embed_query(...):直接计算问题向量。这里调用一次,是为了观察输出有多少个数字。
实际查询时,store 会自动调用 embed_query(),不需要调用方先手动计算问题向量。
第三步:通过 Retriever 查找资料
让检索器每次最多返回两段。这里主动设置的 k=2 只控制返回数量,不改变比较方法:
1 | retriever = store.as_retriever(search_kwargs={"k": 2}) |
本次实测结果:
1 | 退款审核通过后,款项将在 3 个工作日内原路退回。 |
docs 是一个 Document 列表,doc.page_content 才是每项里面的正文。查询只用了“钱怎么退回来?”,已经找到了描述到账时间和申请步骤的两段资料。
想知道它们为什么排在前面,可以直接查看 store 返回的分数:
1 | for doc, score in store.similarity_search_with_score(question, k=3): |
这里的 f"{score:.4f}" 表示保留四位小数。实测输出如下,运行环境不同可能影响末位数字:
1 | 0.6004 退款审核通过后,款项将在 3 个工作日内原路退回。 |
两段退款说明的得分高于请假说明,所以 k=2 返回了它们。到这里,程序完成的是检索,还没有生成回答。
选读:除了取最相似的几条,还有哪些检索方式?
先跑通上面的相似搜索即可。以后遇到具体问题,再考虑下面这些方法:
| 方式 | 解决什么问题 |
|---|---|
| 相似度阈值 | 候选分数太低时不返回,减少明显不相关的结果;阈值要用自己的资料验证 |
| MMR | 在相关性与多样性之间取舍,减少返回内容重复的片段 |
| 关键词检索,例如 BM25 | 按词项匹配取资料,适合明确的错误码、订单号或接口名 |
| 混合检索 | 结合关键词和向量两路结果,同时利用字面匹配与语义匹配 |
这些方式的配置取决于具体实现。比如本文版本的内存库不支持内置的相似度阈值检索,不能直接照搬其他向量数据库的配置。MMR 也不保证每一条都能回答问题,仍需检查取回的正文。
Retriever 集成目录可以用来查找具体实现。本篇继续使用已经跑通的相似搜索。
6. 用 LCEL 把资料交给模型
LCEL 是 LangChain 用来组合处理步骤的一套写法。本节先逐步调用,再把相同的步骤连成一条链。
现在已经有了 docs,下一步是把这些文档的正文拼在一起,交给提示词模板。下面沿用上一节的 docs 和 question:
1 | parts = [] |
context 是一个字符串,里面包含两段退款资料,中间用空行分开。它只是代码里起的变量名,用来保存本次回答的参考资料。
先看清三个步骤分别做什么
要把资料交给聊天模型,还需要提示词模板和输出解析器:
1 | prompt:把资料和问题填进模板 |
为了先观察调用过程,下面使用 FakeListChatModel。它是 langchain-core 包提供的模拟聊天模型类,通过下面的 import 导入,不需要自行定义。它会返回预先写好的回答,不会阅读资料或进行推理,因此不能用这个结果验证回答质量。
1 | from langchain_core.prompts import ChatPromptTemplate |
model = FakeListChatModel(responses=[...]) 是普通的 Python 对象创建语法:
FakeListChatModel(...)创建一个模拟聊天模型对象,变量model保存这个对象。responses=指定传入的参数名称,用来设置预先准备的回答。[...]是 Python 列表,这里的列表只有一个元素,就是那条退款回答字符串。
创建对象时,只是保存这些预设回答;调用 .invoke() 时,才返回一条回复消息。上面的三次调用依次完成:
prompt.invoke(inputs)把资料和问题填好,得到可交给模型的提示词对象。model.invoke(prompt_value)返回一条回复消息,本例正文是预先写好的句子。parser.invoke(message)取出回复文本,保存到answer。
想检查模型收到的内容,可以打印 prompt_value.to_string(),确认里面确实包含两段退款资料和原问题。
如果 responses 中有多条回答,每次调用会按顺序取一条。取完最后一条后,下一次主动调用 .invoke() 时才会从第一条重新取。例如,另建一个演示对象:
1 | demo_model = FakeListChatModel(responses=["回答 A", "回答 B"]) |
这里的 .content 取出回复消息中的正文。代码有三行 .invoke(),所以返回了三次。只写前两行调用,就只返回 A、B,不会自行产生第三次调用。循环的是回答列表的取用顺序,单次 .invoke() 返回消息后就结束,不会自动继续执行;预设回答用完也不会让整个程序停止。
前面的退款模型只配置了一条回答,因此每次调用都返回同一句,换个问题也不会改变它的回答。
| 把同样的步骤连成一条链
前面对 prompt、model、parser 的三次调用可以改成:
1 | chain = prompt | model | parser |
| 表示按顺序连接这些处理步骤。调用整条链时,前一步的输出会传给下一步,最后返回解析器得到的文本。
写下 prompt | model | parser 只是建好链;调用 chain.invoke(inputs) 才开始执行。 这就是 LCEL 在这个例子里的作用。
本文已经实际运行了检索和这条模拟回答链。接入真实问答服务时,把 model 换成配置好的聊天模型,再核对回答是否有原文依据。
选读:Python 的 | 为什么能连接这些对象?
Python 允许类通过 __or__ 方法定义 | 的行为。LangChain 的提示词、模型和解析器都支持 Runnable 接口,可以通过 .invoke() 调用。
在本文使用的 langchain-core 1.6.6 中,Runnable 的组合方法可以简化成下面两行。这里只展示“两个 Runnable 组合”的机制,省略实际源码中的类型转换:
1 | # 简化源码,不作为独立程序运行。 |
执行 prompt | model 时,self 是 prompt,other 是 model,返回的 RunnableSequence 保存了它们的执行顺序。后面再接 parser,就组成了三步流程。
顺序链执行时的数据传递,可以理解成下面的循环:
1 | # 调用机制示意,不是完整源码。 |
循环依次取出 prompt、model、parser,把上一步的结果交给下一步。因此,连接时仍要注意数据是否合适:例如 Retriever 返回文档列表,就需要先像本节开头那样取出正文,再填入模板。
原始实现还包含配置、回调等处理,当前不必逐行阅读。需要时可对照 Runnable 的组合方法和 RunnableSequence.invoke。
7. 用自己的问题再试一次
可以下载 完整退款检索与 LCEL 示例,安装第 5 节的依赖后运行:
1 | python retrieval_demo.py |
完整示例的运行结果如下,可以对照看到三个片段、512 维向量、检索结果和相似度分数:
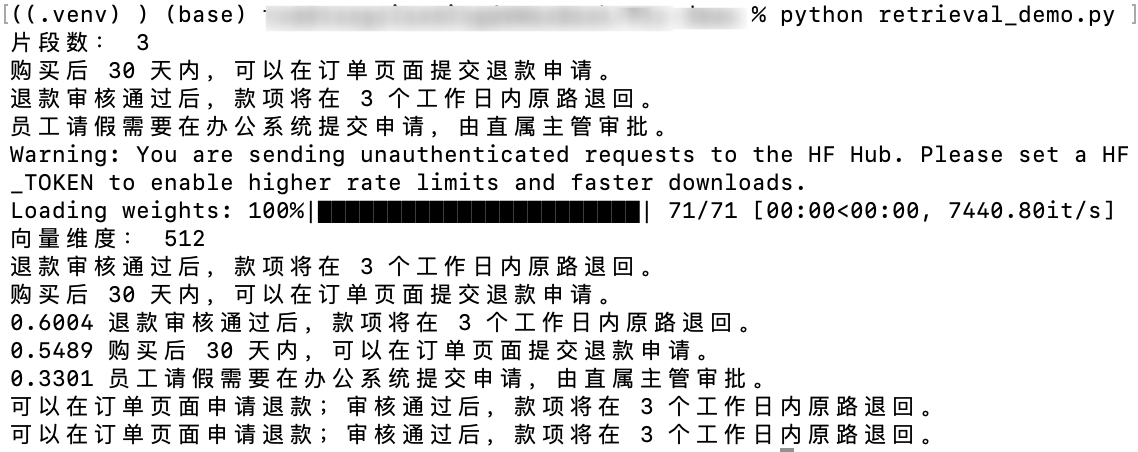
最后两行相同的退款回答,分别来自逐步调用和 LCEL 链调用,两次使用的都是预设回答。
先把 question 改成“请假找谁审批?”,只观察检索得到的正文和分数,再把 as_retriever 中的 k 改成 1,看返回数量怎样变化。最后试着问资料里没有的问题,例如“能退运费吗?”,检查检索结果能否支持回答。
示例中的模型回答是固定的,修改问题后也不会跟着变化。做这些练习时,先检查检索返回的资料是否相关,再接入真实聊天模型,检查回答是否有资料依据,以及资料不足时能否说明无法确认。
这是一种便于排查问题的调试顺序。实际开发需要查询知识库的 Agent 时,也可以先接入真实模型、跑通完整流程,再分别调试检索和回答。关键是分清问题出在哪个环节:是没有找到相关资料,还是找到了资料却回答错误。本文使用模拟模型是为了方便观察调用流程,实际项目不要求先使用模拟模型。